Tinc mem: un Frinkiac de Plats bruts fet per agents
Sempre que busco un mem o un GIF per enviar a algun grup, acabo a The Office. M'agrada molt, i a internet n'hi ha milers, de qualsevol moment de la sèrie. Amb la cultura catalana no passa. Si vols respondre amb el David dient «ah, vale» o amb la Sra. Carbonell, has de buscar el capítol, trobar el minut i fer una captura de pantalla.
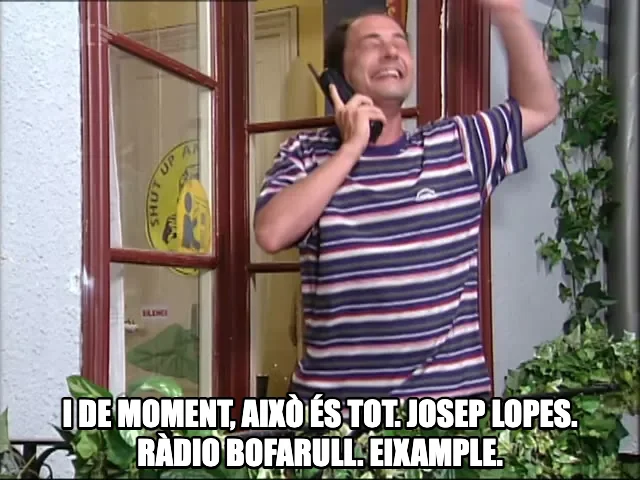
Els Simpson tenen Frinkiac: escrius una frase, et surt el fotograma, hi poses text i el comparteixes. Vaig pensar que Plats bruts també es mereixia el seu, i que ara mateix fer-lo hauria de ser fàcil. Així va néixer tincmem.cat.
En resum
- Cerques qualsevol frase dels 73 capítols de Plats bruts, tries el fotograma i en fas un mem o un GIF.
- No he escrit cap línia: ho ha fet un agent. Jo vaig posar l'objectiu i el vaig dirigir en uns quants punts clau.
- No calia transcriure res: els subtítols de 3Cat ja hi eren, i el color de cada línia diu qui parla.
- El pipeline tria 69.520 fotogrames a partir de 31.295 frases: el més nítid de cada moment i sense repetir plans.
- També el poden fer servir els agents:
llms.txt, respostes en Markdown i un servidor MCP. Un bot de SEO em va esgotar la quota gratuïta de Cloudflare. - El codi era la part fàcil; la difícil, que les dades fossin bones.
El prompt: un objectiu
Fa poc vaig explicar com programo ara: defineixo un objectiu i l'agent treballa fins que la feina està feta. Tinc mem n'és un exemple extrem. Opus 5.5 acabava de sortir i el volia posar a prova, així que li vaig donar el mínim: un projecte inspirat en Frinkiac però per a Plats bruts, que primer estudiés com ho havien fet i després em digués quina infraestructura caldria. Res de tecnologies, d'on treure els capítols o com havia de ser la web.
Després sí que hi vaig posar criteri: provar-ho primer amb un sol capítol, la cerca amb BM25, el servidor MCP, el nom i el domini, i arreglar els GIFs quan vaig veure que a l'iPhone no s'acabaven mai.
Jo m'imaginava que caldria transcriure l'àudio amb algun model de veu i alinear el text amb el vídeo. L'agent va anar per un altre camí. Va trobar els capítols a l'API de 3Cat i, al mateix lloc que el vídeo, els subtítols en català en format VTT. La transcripció ja existia, amb els temps exactes de cada frase.
El primer commit és del 23 de setembre i funcionava amb un sol capítol. El 25 ja era a tincmem.cat amb domini propi. Una setmana i 39 commits després, la web és la que pots veure ara.
Cinc dies després del primer commit ja sortia a la premsa: Nació Digital, Racó Català i El Món a RAC1 se'n van fer ressò.
Els subtítols ja diuen qui parla
La sorpresa més gran van ser els colors. Els subtítols de TV3 fan servir colors per distingir els personatges principals, i el VTT ho guarda amb una etiqueta per parlant. Al primer capítol, quan el David es retroba amb el Lopes:
00:06:04.440 --> 00:06:05.920
<c.yellow>Perdona, tu no ets el Lopes?</c>

00:06:06.960 --> 00:06:10.000
<c.cyan>Ens coneixem?</c>
<c.yellow>Sóc el David. El David Güell!</c>
Groc és el David, cian el Lopes, verd l'Emma i fúcsia la Sra. Carbonell. Però el fitxer no ho diu enlloc: diu yellow, no David. L'agent ho va deduir del context, mirant a qui anomenen els altres just abans o després de cada frase. Aquí mateix ho tens: el groc diu «Sóc el David». Amb prou frases, la correspondència és clara.
Gràcies a això, a la web pots filtrar per personatge. Busques «vale» i pots quedar-te només amb les del David. Un subtítol amb dues persones parlant, com el de l'exemple, es parteix en dues frases, una per parlant, i les cançons es marquen a part.
De capítol a fotograma
Tenir la frase i el moment exacte no és tenir un bon fotograma. Agafar el primer fotograma de cada subtítol dona molts mals resultats: cares a mig parpelleig, imatges mogudes o el pla anterior abans del tall. El pipeline fa quatre passos per a cada capítol.
1. Canvis de pla. ffmpeg detecta on canvia el pla amb el seu filtre de detecció d'escenes. Això serveix per dues coses: posar un moment candidat just després de cada tall (els plans sense diàleg també poden ser bons mems) i saber a quin pla pertany cada fotograma.
2. Tres moments per frase. De cada frase en surten tres candidats: just després de començar, al mig i just abans d'acabar. Una frase llarga sovint té més d'una cara aprofitable. Els moments massa junts (a menys de 0,4 segons) es fusionen.
3. El més nítid de tres. De cada moment se'n treuen tres fotogrames separats per una fracció de segon, i es queda el que té les vores més marcades. La mesura és la variància d'un filtre laplacià: una imatge moguda té les vores esborrades i dona un valor baix. És un truc senzill que elimina gairebé tots els fotogrames borrosos.
4. Fora els repetits. Dins d'un mateix pla, si el David parla tres frases seguides sense moure's, en surten tres fotogrames quasi idèntics. El pipeline redueix cada imatge a 16×12 píxels en gris, la compara amb les que ja ha desat del mateix pla i, si la diferència mitjana és molt petita, la descarta.
A més, per a cada capítol genera miniatures, un vídeo petit (400×300) per fer GIFs directament al navegador i una imatge de previsualització amb el subtítol cremat, perquè quan comparteixes un enllaç ja es vegi el mem.
Cada capítol original pesa uns 860 MB, i el pipeline l'esborra en acabar. Al final, els 73 capítols són 31.295 frases i 69.520 fotogrames.
Una web estàtica (i R2)
Tota la web és un sol index.html. La cerca és al navegador, amb MiniSearch; els GIFs es fan al navegador amb gifenc a partir del vídeo petit, i els fotogrames de cada capítol només es baixen quan calen.
La part estàtica són uns 12 MB, sobretot les frases en JSON, i va en un Worker de Cloudflare. Els fotogrames no hi caben: els fitxers estàtics dels Workers tenen un límit de 20.000 fitxers i aquí n'hi ha més de 69.000 només de fotogrames. Van a R2, l'emmagatzematge d'objectes de Cloudflare, amb un domini propi.
Aquí hi va haver un cas de CORS que val la pena explicar. Per copiar imatges i fer GIFs, el navegador necessita capçaleres CORS a R2. Però la memòria cau de Cloudflare no fa cas de Vary: Origin: si una sola petició sense Origin (un crawler, la previsualització d'un enllaç) arriba primer, la memòria cau guarda la resposta sense CORS, i després la web veu imatges trencades. La solució va ser una Transform Rule que posa Access-Control-Allow-Origin: * a tot el domini dels mitjans, i demanar sempre les imatges amb crossorigin.
El nom, per cert, també té la seva història. L'agent el va batejar Platsiac, i després va proposar «Tinc meme»: gairebé tots els capítols de la primera temporada es diuen «Tinc alguna cosa», com Tinc pis, Tinc por o Tinc enveja. Jo hi vaig canviar meme per «mem», la forma que recomana el TERMCAT, i tincmem.cat estava lliure. I si vas a una adreça que no existeix, la pàgina d'error és un fotograma del T6C12 on l'Emma diu: «No existeix! Te l'has inventada!».
També per a agents
Com que l'agent ho feia tot, li vaig demanar que la web també la poguessin fer servir altres agents. Ho va fer Claude, en dues tandes. La primera, a la mateixa sessió local que el pipeline: el servidor MCP, el llms.txt, un robots.txt que ho deixa rastrejar tot, el sitemap i les dades estructurades. La segona, tres dies després, en una sessió de Claude Code al núvol que va acabar en una PR: el Markdown, les imatges directes i la cerca sense índex.
La web es pinta amb JavaScript, i un agent que la llegeixi només hi troba els botons i l'ajuda del teclat, cap frase. Per això té:
- Un
llms.txtque explica com fer-la servir. - Cerca i fotogrames en Markdown:
tincmem.cat/index.md?q=…o qualsevol enllaç ambAccept: text/markdown. - La imatge directa d'un fotograma, amb el subtítol cremat, afegint
.jpga l'enllaç. Es pot posar en un<img>o en Markdown. - Un servidor MCP a
mcp.tincmem.cat/mcpperquè un assistent pugui cercar frases i retornar el fotograma.
Així, pots demanar a Claude «busca'm un mem de Plats bruts per dir que no tinc ganes d'anar a la feina» i et torna la imatge.
Un bot em va deixar sense quota
Cada fotograma té la seva adreça (/T1C1/642400/213) i una previsualització que genera el Worker. El sitemap en llista més de 31.000, una per frase. Vaig donar d'alta la web a Google Search Console i, poques hores després, va caure: s'havia acabat la quota gratuïta de Workers, 100.000 peticions al dia per compte. El primer sospitós era Google, però les dades deien una altra cosa. Entre el 25 i el 29 de setembre, Googlebot no va arribar a 2.000 peticions, i AhrefsBot, un rastrejador de SEO, en va fer unes 260.000. I com que la quota és per compte, també va caure el servidor MCP.
La solució immediata va ser el pla de pagament de Workers, 5 dòlars al mes, i en 30 segons tornava a funcionar. El dia abans, la sessió al núvol ja havia preparat un canvi per treure feina al Worker, i el vaig desplegar just després. D'una banda, la portada ja no hi passa, i això són moltes menys peticions. De l'altra, la cerca dels agents no construeix cap índex. Això no era per la quota sinó per la CPU: el pla gratuït només deixa 10 ms per petició, i muntar l'índex de MiniSearch en trigava entre 400 i 700. Ara és una cerca lineal sobre un fitxer de text pla, que hi cap de sobres.
Analítiques sense cookies
Volia saber què passava sense posar cookies ni banners de consentiment. Faig servir dues coses:
- Cloudflare Web Analytics per a visites i pàgines. Com que la web navega amb
pushState, vaig haver d'activar-hi els canvis d'historial perquè comptés cada fotograma com una vista. - Esdeveniments propis (cerques, fotogrames vistos, accions) que el Worker envia a Cloudflare Analytics Engine, i un petit script que els consulta.
Teresina S.A., al calaix
Com que el pipeline és genèric (una configuració per sèrie: l'id del programa a 3Cat, el color de cada personatge i l'estil de la web), vaig provar-ho amb Teresina S.A. El codi funcionava, però el resultat no em va convèncer: els fotogrames no sempre coincidien amb qui parlava i hi havia parts en castellà. Ara és al calaix.
És un bon recordatori que la part difícil d'aquest projecte no era el codi: era que les dades fossin bones. A Plats bruts ho són. Els subtítols són fidels, els colors són consistents i el pla acostuma a mostrar qui parla.
Si trobes una frase que no surt, o en fas un mem que valgui la pena, escriu-me. I si no, ja saps: tincmem.cat.